数据结构简单要点总结(转)
栈
栈是只能在一端进行插入和删除的线性表。
(别看只是个定义,非常重要,已经道出了运算方法:只能在一端插入和删除。)
栈的特征:后进先出,先进后出。
插入和删除元素的一端称为栈顶。(说明了我们在栈顶操作)
另一端称为栈底。
插入元素和删除元素的操作称为入栈和出栈。
顺序栈
结构:(top总是指向数组最后的元素,比如data[n],而不是前面)
1 |
|
初始化栈:
1 | void init_stack(seqstack *S) |
判断栈是否为空:
1 | int stack_empty(seqstack *S) |
取栈顶元素:
1 | elementtype stack_top(seqstack *S) |
入栈:
1 | void push_stack(seqstack *S, elementtype x) |
出栈:
1 | elementtype pop_stack(seqstack *S) |
判断栈是否为满:
1 | int stack_full(seqstack *S) |
总体来说,顺序栈很简单,出的时候取最后的元素,进的时候一样进在尾部。
链栈
栈的链式存储结构称为链栈。
其插入和删除操作仅限制在表头位置上进行。
由于只能在链表头部进行操作,故链栈没有必要象单链表那样添加头结点。栈顶指针就是链表的头指针。
结构:
1 | typedef struct node //和一般链表的结构一样。 |
当top=NULL时,链栈为空栈。
入栈:
1 | void push_stack(linkstack *top, elementtype x) |
出栈:
1 | elementype pop_stack(linkstack *top) |
队列
队列是只能在一端插入,另一端删除的线性表。
特征是:先进先出,后进后出。
顺序队列
注意顺序队列多是循环队列,这里要注意几点:
(1)front是队头的前一个位置。
(2)尾部入队,头部出队。
(3)由于循环,任何的位置移动计算之后要取余:$P = (P + 1) % MAXSIZE $。
结构:
1 |
|
初始化队列:
1 | void init_queue(seqqueue *Q) |
还有一种写法:
1 | void init_queue(seqqueue *Q) |
两种方法的区别是第一种插入第一个元素是data[1],而第二种是data[0]。
判断队列是否为空:
1 | int queue_empty(seqqueue *Q) |
判断队列是否为满:
1 | int queue_full(seqqueue *Q) |
取队头元素:
1 | elementtype queue_front(seqqueue *Q) |
入队:
1 | void Enqueue(seqqueue *Q, elementtype x) |
出队:
1 | elementtype Outqueue(seqqueue *Q) |
链队列
出队时,删除表头操作,入队时,在表尾添加结点。(也就是头部出,尾部进)
使用带头结点的单链表形式。(注意链栈是不带头结点的)
结构:
1 | typedef struct mynode |
初始化队列:
1 | void init_queue(linkqueue *Q) |
判断队列是否为空:
1 | int queue_empty(linkqueue *Q) |
取队头元素:
1 | elementtype queue_front(linkqueue *Q) |
入队:
1 | void Enqueue(linkqueue *Q, elementtype x) |
出队:
1 | elementtype Outqueue(linkqueue *Q) |
数组
主要是稀疏矩阵的压缩存储:
当数组中非零元素非常少时,称之为稀疏矩阵。
存储特别如下:
(1)对稀疏矩阵压缩存储时,除了存储非零元素的值v以外,还要存储其行列号i和j,故每个元素对应一个三元组(i, j, v)。将这些元素的三元组组织起来构成三元组表。
(2)需要在三元组表中增设元素个数、行列数,以唯一确定一个稀疏矩阵。
结构如下:
1 |
|
树
树
树中的每个结点最多只有一个前驱(父辈),但可能有多个后继(后代)。
一个结点的度是指该结点的孩子数目。
若一个结点的度为0,称为叶子结点或终结点,否则称为分支结点或非终结点。
一棵树的度是树中最大的结点的度。
某个结点的子树的根称为其孩子结点,而该结点为其孩子结点的双亲结点或父结点。
同一个结点的孩子互相称为兄弟结点。
根的层次为1,其余结点的层次为父结点的层次数加1,而最大的层次数称为树的高度或深度。
如果树中各兄弟结点之间的排列次序是无关的,则称之为有序树,否则称为无序树。
称多棵树为森林。
二叉树
二叉树和树一样,都可以为空树。
注意二叉树每个结点的孩子都有左右之分,每个结点都有左右两个子树,这与树结构明显不同。
二叉树和树本质上是完全不同的两种结构。
定义:满二叉树是指每层都有最大数目结点的二叉树,即高度为k的满二叉树中有2k-1个结点。而完全二叉树则是指在满二叉树的最下层从右到左连续地删除若干个结点所得到的二叉树。
二叉树的性质:
在二叉树的第i层上的结点个数$<=2^{i-1}$(i>0)
深度(高度)为k的二叉树的结点个数$<=2^k-1$
3.对任一棵非空的二叉树,如果其叶子数为$n_0$, 度为2的结点数为$n_2$, 则有下面的关系式成立:$n_0=n_2+1$
(这个性质很重要。主要是有个概念:除去根结点,每个结点都与一个它上面的分支一一对应,也就是说,结点数=分支数+1,所以有:$n-1=n_1+2*n_2$)
4.有n个结点的完全二叉树(n>0)的深度为[log2n]+1([]为取整)
5.在编号的完全二叉树中,各结点的编号之间的关系为:
编号为i的结点如果存在左孩子,则其编号为2i,如果存在右孩子,则其编号为2i+1,如果存在父结点,则其编号为[i/2]。
二叉树的存储结构:
顺序存储结构:
按完全二叉树的编号次序进行,即编号为i的结点存储在数组中下标为i的元素中。
缺点:若二叉树不是完全二叉树,则为了保持结点之间的关系,不得不空出许多元素来,这就造成了空间的浪费。
二叉链表存储结构:
1 | typedef struct node |
二叉树的遍历:
所谓遍历二叉树是指按某种次序访问二叉树中每个结点一次且仅一次。
根据访问根结点的次序,可以分为先序遍历,中序遍历,后序遍历。
先序遍历可描述为:
若二叉树T不为空:
(1)访问T的根结点;
(2)先序遍历T的左子树;
(3)先序遍历T的右子树。
遍历的算法非常简单,只写出先序遍历算法:
1 | void preorder(bitree *T) |
线索二叉树
线索二叉树主要是为了求解在某种次序下的前驱或后继结点。
将二叉树各结点中的空的左孩子指针域改为指向其前驱,空的右孩子指针域改为指向其后继。称这种新的指针(前驱或后继)为线索,所得到的二叉树被称为线索二叉树,将二叉树转变成线索二叉树的过程称为线索化。
同时,为了区分到底指针是指向前驱(后继)还是孩子,要加入两个标志来判断。
结构:
1 | typedef struct node |
先序后继的求解:
1 | ordertree *presuc(ordertree *P) |
中序后继:
1 | ordertree *insuc(ordertree *P) |
中序先驱:
1 | ordertree *infore(ordertree *P) |
后序先驱:
1 | ordertree *postfore(ordertree *P) |
二叉查找树
即二叉搜索树或二叉排序树:
1.所有非叶子结点至多拥有两个儿子(Left和Right);
2.所有结点存储一个关键字;
3.非叶子结点的左指针指向小于其关键字的子树,右指针指向大于其关键字的子树;
如: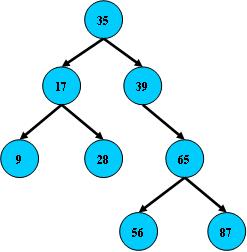
查找树的搜索,从根结点开始,如果查询的关键字与结点的关键字相等,那么就命中;否则,如果查询关键字比结点关键字小,就进入左儿子;如果比结点关键字大,就进入右儿子;如果左儿子或右儿子的指针为空,则报告找不到相应的关键字;如果查找树的所有非叶子结点的左右子树的结点数目均保持差不多(平衡),那么查找树的搜索性能逼近二分查找;但它比连续内存空间的二分查找的优点是,改变查找树结构(插入与删除结点)不需要移动大段的内存数据,甚至通常是常数开销;
如: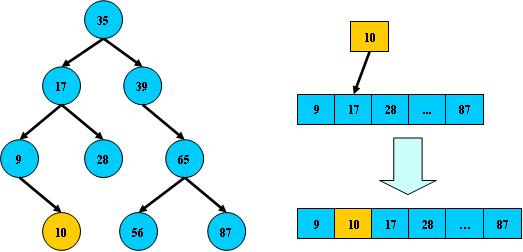
但查找树在经过多次插入与删除后,有可能导致不同的结构: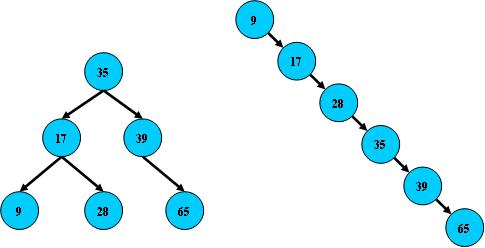
右边也是一个查找树,但它的搜索性能已经是线性的了;同样的关键字集合有可能导致不同的树结构索引;所以,使用查找树还要考虑尽可能让B树保持左图的结构,和避免右图的结构,也就是所谓的“平衡”问题;
实际使用的B树都是在原查找树的基础上加上平衡算法,即“平衡二叉树”;如何保持查找树结点分布均匀的平衡算法是平衡二叉树的关键;平衡算法是一种在B树中插入和删除结点的策略;
B-树
是一种多路搜索树(并不是二叉的):
1.定义任意非叶子结点最多只有M个儿子;且M>2;
2.根结点的儿子数为[2, M];
3.除根结点以外的非叶子结点的儿子数为[M/2, M];
4.每个结点存放至少M/2-1(取上整)和至多M-1个关键字;(至少2个关键字)
5.非叶子结点的关键字个数=指向儿子的指针个数-1;
6.非叶子结点的关键字:K[1], K[2], …, K[M-1];且K[i] < K[i+1];
7.非叶子结点的指针:P[1], P[2], …, P[M];其中P[1]指向关键字小于K[1]的子树,P[M]指向关键字大于K[M-1]的子树,其它P[i]指向关键字属于(K[i-1], K[i])的子树;
8.所有叶子结点位于同一层;
如:(M=3)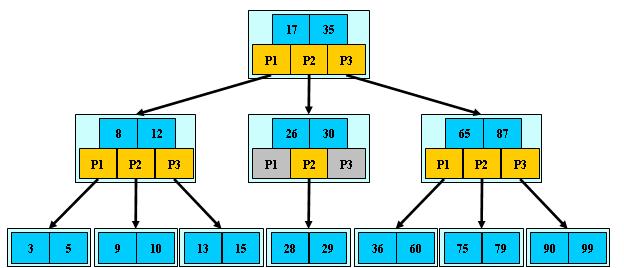
B-树的搜索,从根结点开始,对结点内的关键字(有序)序列进行二分查找,如果命中则结束,否则进入查询关键字所属范围的儿子结点;重复,直到所对应的儿子指针为空,或已经是叶子结点;
B-树的特性:
1.关键字集合分布在整颗树中;
2.任何一个关键字出现且只出现在一个结点中;
3.搜索有可能在非叶子结点结束;
4.其搜索性能等价于在关键字全集内做一次二分查找;
5.自动层次控制;
由于限制了除根结点以外的非叶子结点,至少含有M/2个儿子,确保了结点的至少利用率,其最底搜索性能为: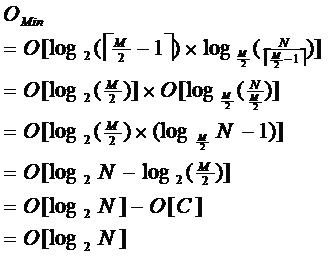
其中,M为设定的非叶子结点最多子树个数,N为关键字总数;所以B-树的性能总是等价于二分查找(与M值无关),也就没有B树平衡的问题;由于M/2的限制,在插入结点时,如果结点已满,需要将结点分裂为两个各占M/2的结点;删除结点时,需将两个不足M/2的兄弟结点合并;
B+树
B+树是B-树的变体,也是一种多路搜索树:
1.其定义基本与B-树同,除了:
2.非叶子结点的子树指针与关键字个数相同;
3.非叶子结点的子树指针P[i],指向关键字值属于[K[i], K[i+1])的子树
(B-树是开区间);
5.为所有叶子结点增加一个链指针;
6.所有关键字都在叶子结点出现;
如:(M=3)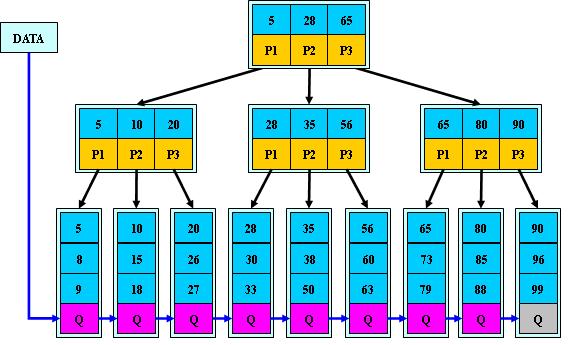
B+的搜索与B-树也基本相同,区别是B+树只有达到叶子结点才命中(B-树可以在非叶子结点命中),其性能也等价于在关键字全集做一次二分查找;
B+的特性:
1.所有关键字都出现在叶子结点的链表中(稠密索引),且链表中的关键字恰好是有序的;
2.不可能在非叶子结点命中;
3.非叶子结点相当于是叶子结点的索引(稀疏索引),叶子结点相当于是存储(关键字)数据的数据层;
4.更适合文件索引系统;
B*树
是B+树的变体,在B+树的非根和非叶子结点再增加指向兄弟的指针;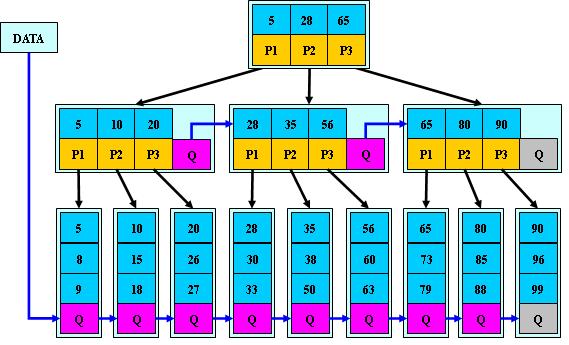
B*树定义了非叶子结点关键字个数至少为(2/3)*M,即块的最低使用率为2/3(代替B+树的1/2);
B+树的分裂:
当一个结点满时,分配一个新的结点,并将原结点中1/2的数据复制到新结点,最后在父结点中增加新结点的指针;B+树的分裂只影响原结点和父结点,而不会影响兄弟结点,所以它不需要指向兄弟的指针;
B*树的分裂:
当一个结点满时,如果它的下一个兄弟结点未满,那么将一部分数据移到兄弟结点中,再在原结点插入关键字,最后修改父结点中兄弟结点的关键字(因为兄弟结点的关键字范围改变了);如果兄弟也满了,则在原结点与兄弟结点之间增加新结点,并各复制1/3的数据到新结点,最后在父结点增加新结点的指针;所以,B*树分配新结点的概率比B+树要低,空间使用率更高;
小结
B树:二叉树,每个结点只存储一个关键字,等于则命中,小于走左结点,大于走右结点;
B-树:多路搜索树,每个结点存储M/2到M个关键字,非叶子结点存储指向关键字范围的子结点;所有关键字在整颗树中出现,且只出现一次,非叶子结点可以命中;
B+树:在B-树基础上,为叶子结点增加链表指针,所有关键字都在叶子结点中出现,非叶子结点作为叶子结点的索引;B+树总是到叶子结点才命中;
B*树:在B+树基础上,为非叶子结点也增加链表指针,将结点的最低利用率从1/2提高到2/3;
树和森林
树的存储结构:
(1)双亲表示法
1 | struct tnode |
其中parent指示该结点父结点的下标,data存放结点的值。
优点:便于搜索相应结点的父结点和祖先结点。
缺点:若要搜索孩子结点或后代结点需要搜索整个表,浪费时间。
(2)孩子链表表示法
分别将每个结点的孩子结点连成一个链表,然后将各表头指针放在一个表中构成一个整体结构。
1 | typedef struct node //链表中每个孩子结点的定义 |
优缺点:与双亲表示法恰好相反。
(3)孩子-兄弟链表表示法(二叉链表表示法,二叉树表示法)
树中每个结点用一个链表结点来存储,每个链表结点中除了存放结点的值外,还有两个指针,一个用来指示该结点的第一个孩子,另一个用于指示该结点的下一个兄弟结点。
1 | typedef struct node |
树(森林)与二叉树的转换
树或森林的子树转换为二叉树的左子树,兄弟转化为右子树。
3.树(森林)的遍历
树的遍历可分为先序遍历和后序遍历。(注意没有中序,因为树有不只两个孩子)即结点是在其子树之前还是之后访问。
遍历树(森林)要转换为遍历其对应的二叉树:
先序遍历:(同二叉树的先序遍历)
1 | void preorder(tnode *T) |
后序遍历:(同二叉树的中序遍历)
1 | void postorder(tnode *T) |
哈夫曼树
哈夫曼树主要用来处理压缩算法。
一般的判断问题的流程就象是一棵二叉树,其中分支(判断)结点对应于二叉树的分支结点;而最后得出的结论对应于叶子结点;一个结论所需要的判断次数是从根结点到该叶子结点的分支线数(层次数-1);每个结论成立的次数作为叶子结点的权值。
(这个权值可能比较少接触,但是其实它非常重要,因为我们平时设计的系统,判断的结果常常都是通过长年的实践会有一个出现机率分配,而不可能是平分的,比如考试,如果常常80-90分的比较多,也许就要换一种算法,当然这是后话,和考试无关了.)
哈夫曼算法步骤如下:
(1)根据给定的n个权值,构成一排结点T,每个的值都是相应的权值.
(2)从T中选两棵权值最小的二叉树,作为左右子树构成一棵新的二叉树T’,并且新二叉树的权值为左右子树权值之和.
(3)将新二叉树T’并入到T中,删除原来的两棵二叉树.
(4)重复2,3直到只剩一棵二叉树.这棵树就是哈夫曼树.
哈夫曼树的带权路径长度$WPL=\sum wL$
即所有叶子结点的 权值*比较次数(层次数-1) 之和.
而WPL也正好等于所有分支结点(不包括叶子结点)的值之和.
图
图中将每个对象用一个顶点表示,并常用一个序号来标识一个顶点。
其中弧表示单向关系,边表示双向关系,用离散数学中的术语来说,则分别表示为非对称关系和对称关系。
弧用<A, B>表示(A为尾,B为头),边用(A, B)表示。
一个图G由两部分内容构成,即顶点(vertex)集合(V)和边(或弧edge)的集合(E),并用二元组(V, E)来表示,记做G = (V, E)
根据顶点间的关系是否有向而引入有向图和无向图。
给每条边或弧加上权值,这样的带权图称为网络。
若无向图中任意两点间都有一条边,则称此图G为无向完全图。(共有边数 $n*(n-1)/2$)
若有向图中任意一个顶点到其余各点间均有一条弧,则称为有向完全图。(共有弧数 $n*(n-1)$)
若一个图G1是从G中选取部分顶点和部分边(或弧)组成,则称G1是G的子图。(注意,顶点和边必须都为子关系)
若无向图中两个顶点i, j之间存在一条边,则称i, j相邻接,并互为邻接点。
在有向图中,若存在弧<Vi, Vj>,也做Vi, Vj相邻接,但为区别弧的头、尾顶点,可进一步称做Vi邻接到Vj,Vj邻接于Vi。
与一个顶点相邻接的顶点数称为该顶点的度。
在有向图中,进入一个顶点的弧数称为该顶点的入度,从一个顶点发出的弧数为该顶点的出度,并将入度和出度之和作为该顶点的度。
一个顶点经过一定的可经路程到达另一个顶点,就为顶点之间的路径。
若某路径所经过的顶点不重复,则称此路径为简单路径。
若某路径的首尾相同,则称此路径为回路(或称为环)。
若某回路的中间不重复,则称之为简单回路。
若无向图中任意两点之间均存在路径,则称G为连通图,否则不连通,就存在若干个连通分量。
若有向图中任意两点间可以互相到达,则称为强连通图。
一个无向图,连通并且无回路,称这样的图为树。
若有向图中仅有一个顶点的入度为0,其余顶点的入度都为1,称此图为有向树,入度为0的顶点为根。
图的存储结构:
1。邻接矩阵表示
对n个顶点的图来说,其邻接矩阵为n*n阶的。
邻接矩阵的元素存放边(弧)的权值,对不存在的边(弧),则用0或∞表示。
定义格式如下:
1 |
|
邻接表表示法
将每个顶点的邻接点连成链表,并将各链表的表头指针合在一起(用数组或链表表示均可),其中每个头指针与该结点的信息合为一个整体结点。
如果将邻接表中各顶点的邻接表变为其前驱顶点即可,从而得到逆邻接表。
用邻接表存储网络时,需要将各条边(弧)的权值作为相应邻接结点中的一个字段。
结构:
1 | typedef struct node |
建立无向图的邻接表:
1 | CreateAdjlist(gnode) |
图的遍历算法及其应用
深度遍历
(1)访问V0
(2)依次从V0 的各个未被访问的邻接点出发深度遍历
(两句话说的非常清楚。是一种以深度为绝对优先的访问。)
2。深度优先搜索遍历算法
由于实际算法比较复杂,这里算法依赖两个函数来求解(对于不同的存储结构有不同的写法)
firstadj(G, v):返回图G中顶点v的第一个邻接点。若不存在,返回0。
nextadj(G, v, w):返回图G中顶点v的邻接点中处于w之后的那个邻接点。若不存在,返回0。
depth first search:
1 | void dfs(graph G, int v) |
如果不是连通图,或者是有向图,那么访问一个v不可能遍历所有顶点。所以,需要再选择未被访问的顶点作为起点再调用dfs.
所以,深度遍历图的算法如下:
1 | void dfs_travel(graph G) |
3.广度优先搜索遍历算法
广度优先搜索遍历算法(bfs)是一种由近而远的层次遍历算法,从顶点V0出发的广度遍历bfs描述为:
(1)访问V0(可作为访问的第一层);
(2)假设最近一层的访问顶点依次为V1, V2, …, Vk,则依次访问他们的未被访问的邻接点。
(3)重复2,直到找不到未被访问的邻接点为止。
1 | void bfs(graph G, int V0) |
广度遍历图的算法和深度一样:
1 | void bfs_travel(graph G) |
最小生成树:
从图中选取若干条边,将所有顶点连接起来,并且所选取的这些边的权值之和最小。
这样所选取的边构成了一棵树,称这样的树为生成树,由于权值最小,称为最小生成树。
构造最小生成树有两种方法:
Prim算法:
首先将所指定的起点作为已选顶点,然后反复在满足如下条件的边中选择一条最小边,直到所有顶点成为已选顶点为止(选择n-1条边):一端已选,另一端未选。
(简单的说,就是先任选一点,然后每次选择一条最小权值的边,而且只连接到一个已选顶点)
Kruskal算法:
反复在满足如下条件的边中选出一条最小的,和已选边不够成回路。
(条件就是不够成回路就OK,反复选最小边,知道所有顶点都有连接)
最短路径:
一般即是要一个顶点到其余各个顶点的最短路径。(比如隔很远的顶点,要绕哪几条边走)
求解方法:
首先,我们要画一个表,每个顶点有path和dist两个值,分别用来存储到各点的最短路径(比如(1,5,6),就是1-5-6这个路径)和相应的长度(到该点的权值之和)。
(1)对V以外的各顶点,若两点间的邻接路径存在,则将其作为最短路径和最短长度存到path[v]和dist[v]中。(实际上也就是最开始对顶点的直接后继进行处理)
(2)从未解顶点中选择一个dist值最小的顶点v,则当前的path[v]和dist[v]就是顶点v的最终解(从而使v成为已解顶点)。
(3)如果v的直接后继经过v会更近一些,则修改v的直接后继的path和dist值。
(上面的确是很难懂,只能通过例子自己慢慢熟悉。)
查找
在软件设计中,通常是将待查找的数据元素集以某种表的形式给出,从而构成一种新的数据结构--查找表。
表包括一些“元素”,“字段”等等概念。
在一个数据表中,若某字段的值可以标识一个数据元素,则称之为关键字(或键)。
若此关键字的每个值均可以唯一标识一个元素,则称之为主关键字,否则,若该关键字可以标识若干个元素,则称之为次关键字。
查找算法的时间性能一般以查找次数来衡量。所谓查找长度是指查找一个元素所进行的关键字的比较次数。常以平均查找次数、最大查找次数来衡量查找算法的性能。
简单顺序查找
1 | int seq_seach(elementtype A[], int n, keytype x) |
监视哨是一个小技巧,查找失败时,这里设定的数据是A1-A[n],肯定可以在A[0]中找到该元素,并返回0表示查找失败。如果不设定监视哨,则在每次循环中要判断下标是否越界:for (i=1; i!=n&&A[i].key!=x;i–); 可以节省一半的时间。
有序表的二分查找
1 | int bin_search(elementtype A[], int n, keytype x) |
也可以使用递归算法:
1 | int bin_search(elementtype A[], int low, int high, keytype x) |
排序
增排序和减排序:如果排序的结果是按关键字从小到大的次序排列的,就是增排序,否则就是减排序。
内部排序和外部排序:如果在排序过程中,数据表中所有数据均在内存中进行,则这类排序为内部排序,否则就是外部排序。
稳定排序和不稳定排序:在排序过程中,如果关键字相同的两个元素的相对次序不变,则称为稳定排序,否则是不稳定排序。
在分析算法的时间性能时,主要以算法中用的最多的基本操作的执行次数(或者其数量级)来衡量,这些操作主要是比较、移动和交换元素。有时,可能要用这些次数的平均数来表示。
插入排序
基本思想:把整个待排序子表看作是左右两部分,其中左边为有序区,右边为无序区,整个排序过程就是把右边无序区中的元素逐个插入到左边的有序区中,以构成新的有序区。
实际中,开始排序时把第一个元素A[0](或A[1])看作左边的有序区,然后把剩下的2~N个元素依次插入到有序表中。
1 | void insert_sort(elementtype A[n+1]) |
明白这种方法的简单原理:
$a_1 a_2 a_3 … a_{i-1} a_i …$
先将ai临时保存起来,然后把$a_{i-1}$向前只要是比$a_i$大的向后移,再把$a_i$填进去即可。
快速排序
速度最快的办法!一定要掌握,考试重点。
基本思想:首先,选定一个元素作为中间元素,然后将表中所有元素与该中间元素相比较,将表中比中间元素小的元素调到表的前面,将比中间元素大的元素调到后面,再将中间数放在这两部分之间作为分界点,这样便得到一个划分;然后再对左右两部分分别进行快速排序,如此反复,直到每个子表仅有一个元素或空表为止。
中间数一般选择部分的第一个元素。
1 | int partition(elementtype A[n], int s, int t) //s,t是要排序元素的起点和终点,并返回最后中间元素位置 |
整个算法:
1 | void quick_sort(elementtype A[n], int s, int t) //对数组中下标从s到t的部分进行快速排序,如果是整个表就是0, n-1 |
选择排序:
在待排序子表中完整地比较一遍以确定最大(小)元素,并将该元素放在子表的最前(后)面。
【注:可能发觉和冒泡法比较类似,但注意选择法是全部比较一遍,找到最小元素的下标,再进行一次交换,而冒泡则是进行多次交换】
1 | void select_sort(elementtype A[n]) |
归并排序
所谓归并是指将两个或两个以上的有序表合并成一个新的有序表。
归并算法:
假设两个序列A[m]和B[n]为非降序列(即存在相同元素的升序列),现要把他们合并为一个非降序列C[m+n]。
1 | void merge(elementtype A[], elementtype B[], elementtype C[], int m, int n) |
部分转自:天堂大鸟