Python 多进程下 logging 日志切分踩坑
起
这个事情从一个新的 tornado 服务说起,这个服务部署到预发布环境之后,会有一个流水线定时每个小时触发访问塞数据到这个服务,但是每天晚上12点服务会产生大量的CLOSE_WAIT,导致所有进程被阻塞,整个服务失效。
回顾 TIME_WAIT 和 CLOSE_WAIT 相关知识可以自行 Google ,重点就是一句话:CLOSE_WAIT 问题一定出在自己的代码里面
承
查日志发现没有日志…
一开始我怀疑是全局 MongoDB Client 存在进程安全问题,于是把MongoDB Client 放到了数据类当中,并且每次数据类__del__的时候会close连接。重启服务,弄了一个循环跑了一千次,怼了几十万次数据,一觉睡醒啥事儿没有。以为搞定了。
结果…第二天12点又出现了…CLOSE_WAIT
转
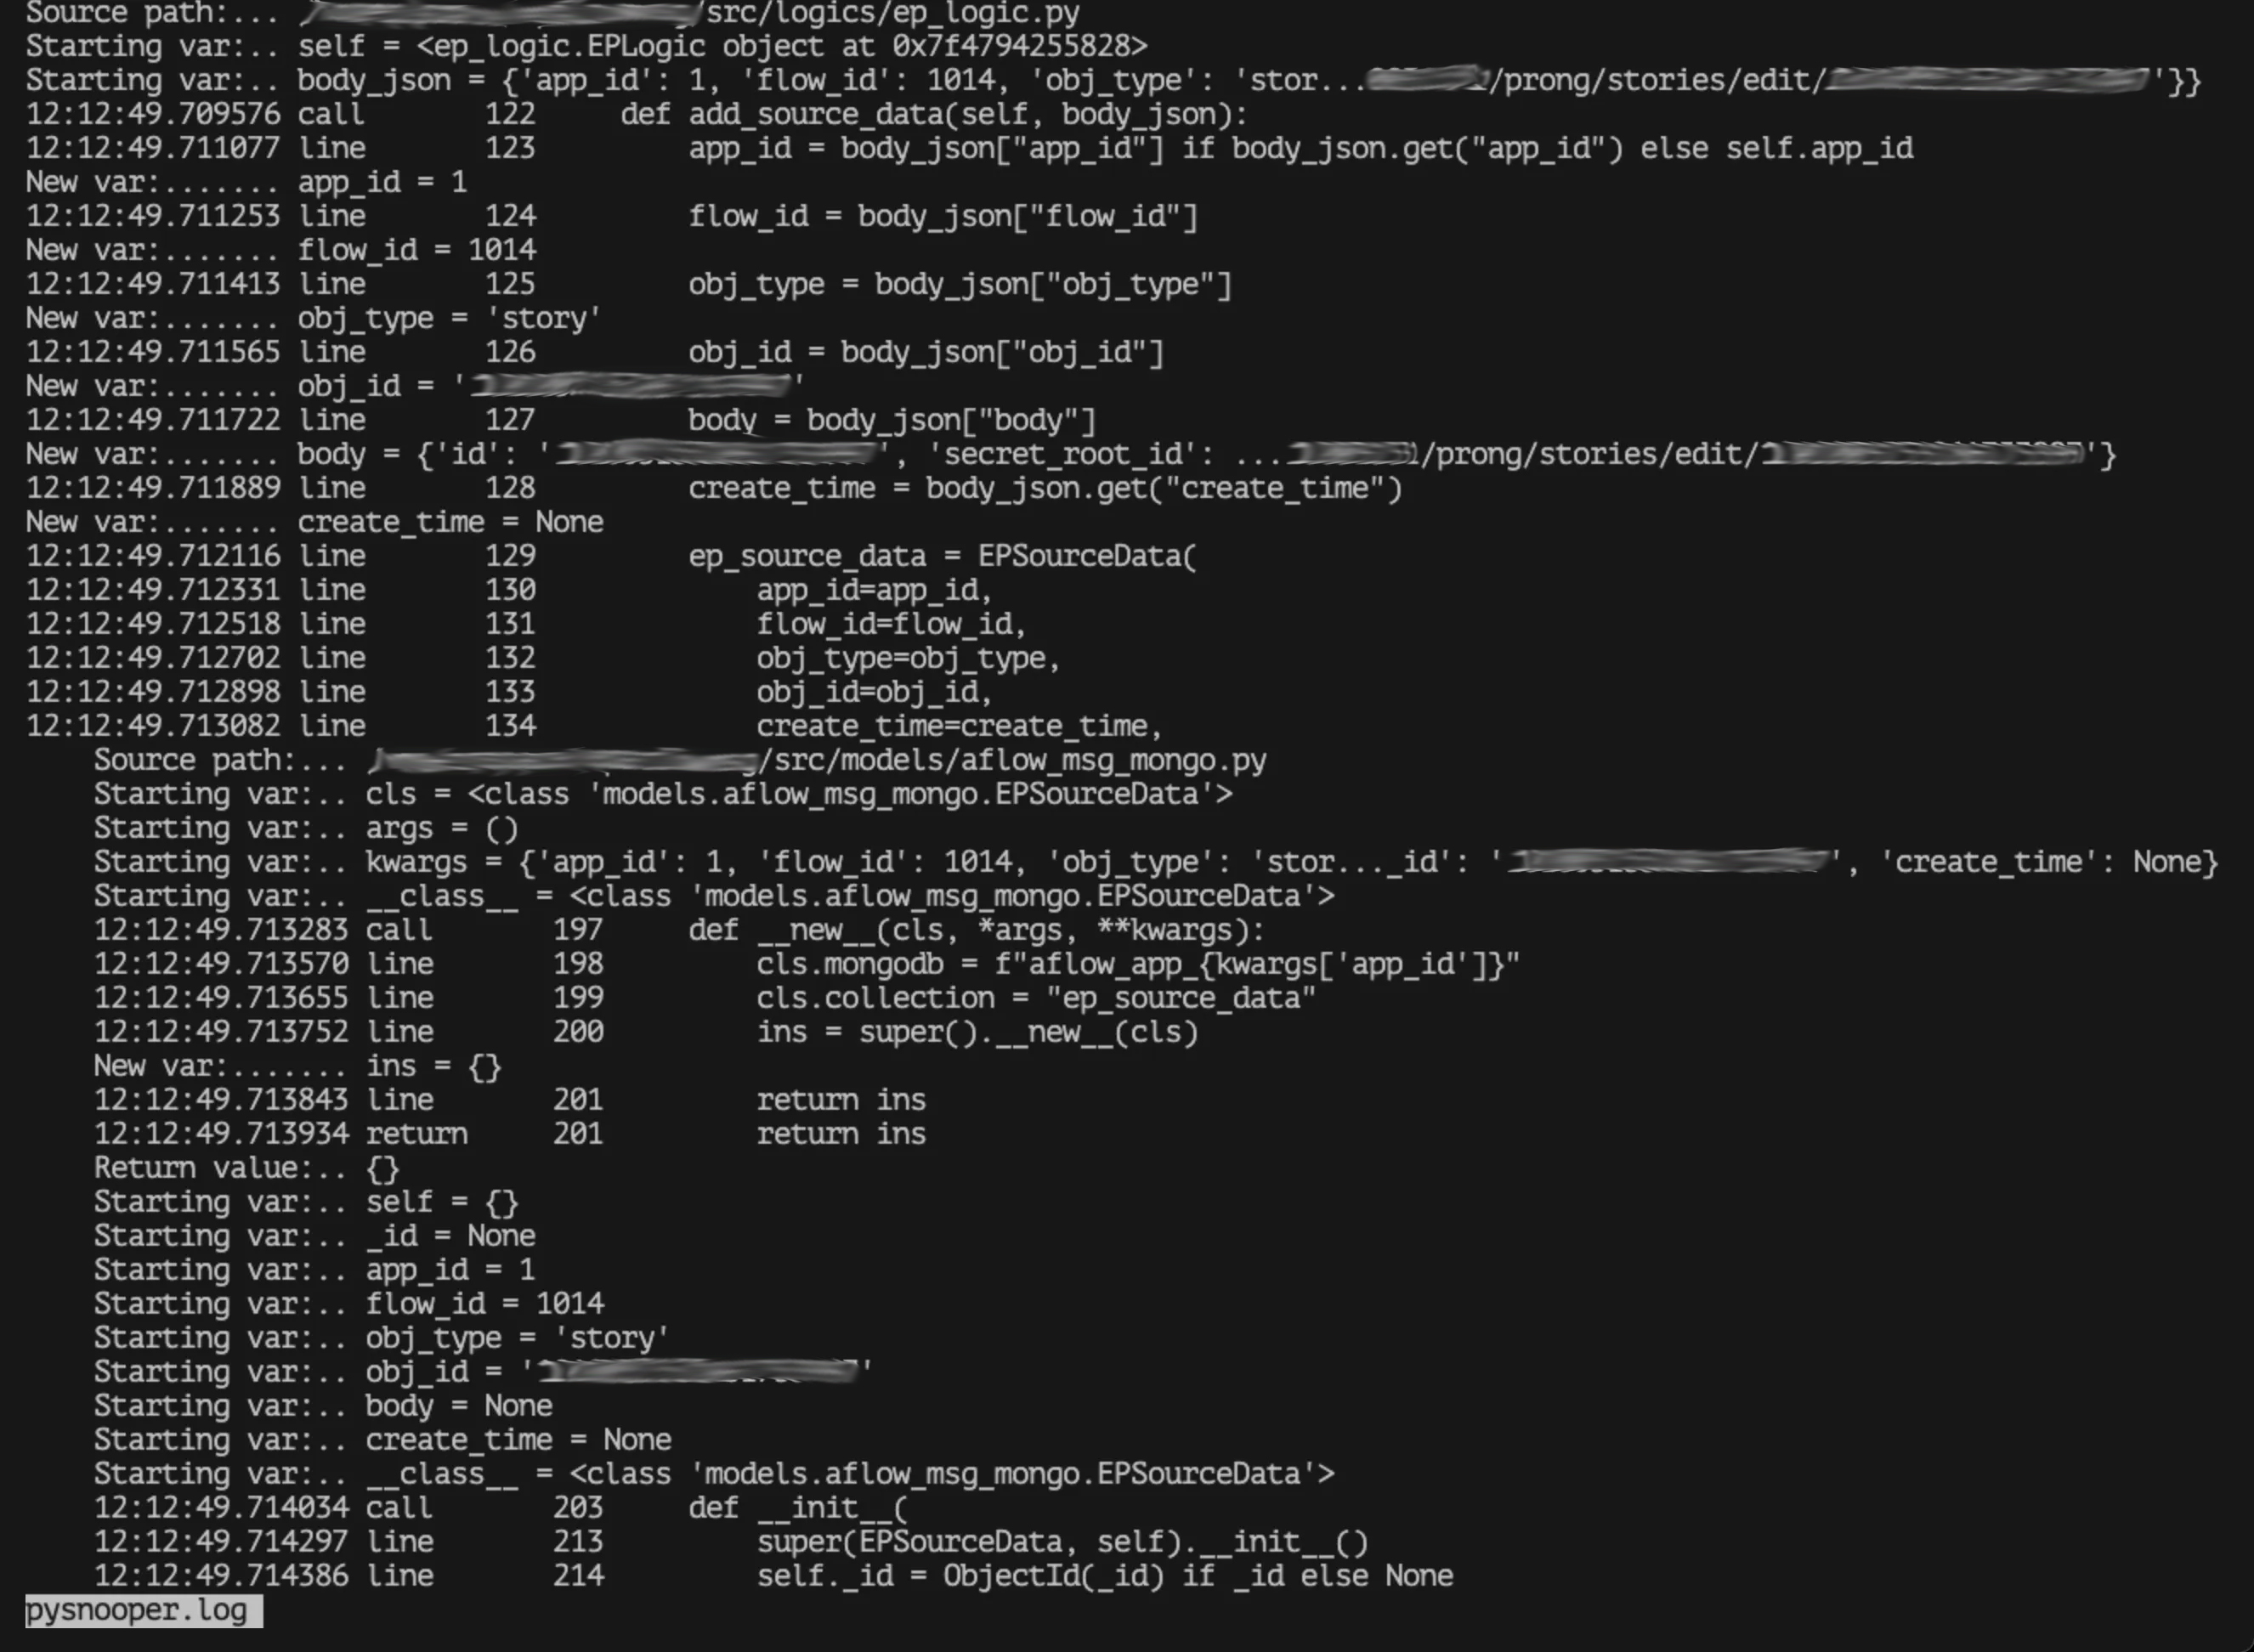
依然没有日志,无奈只能用 pysnooper 来调试接口,把堆栈打出来,看看卡在哪里了。(这是依然不知道问题在哪里)重启服务就没问题…
这里先夸一下 pysnooper,可以让你直接在服务器上面获得调试能力
1 |
|
可以指定日志输出的路径,以及堆栈深度。会把过程中赋值的结果都打印出来。
又到了 12 点…
这次终于让 pysnooper 捕捉到了信息。
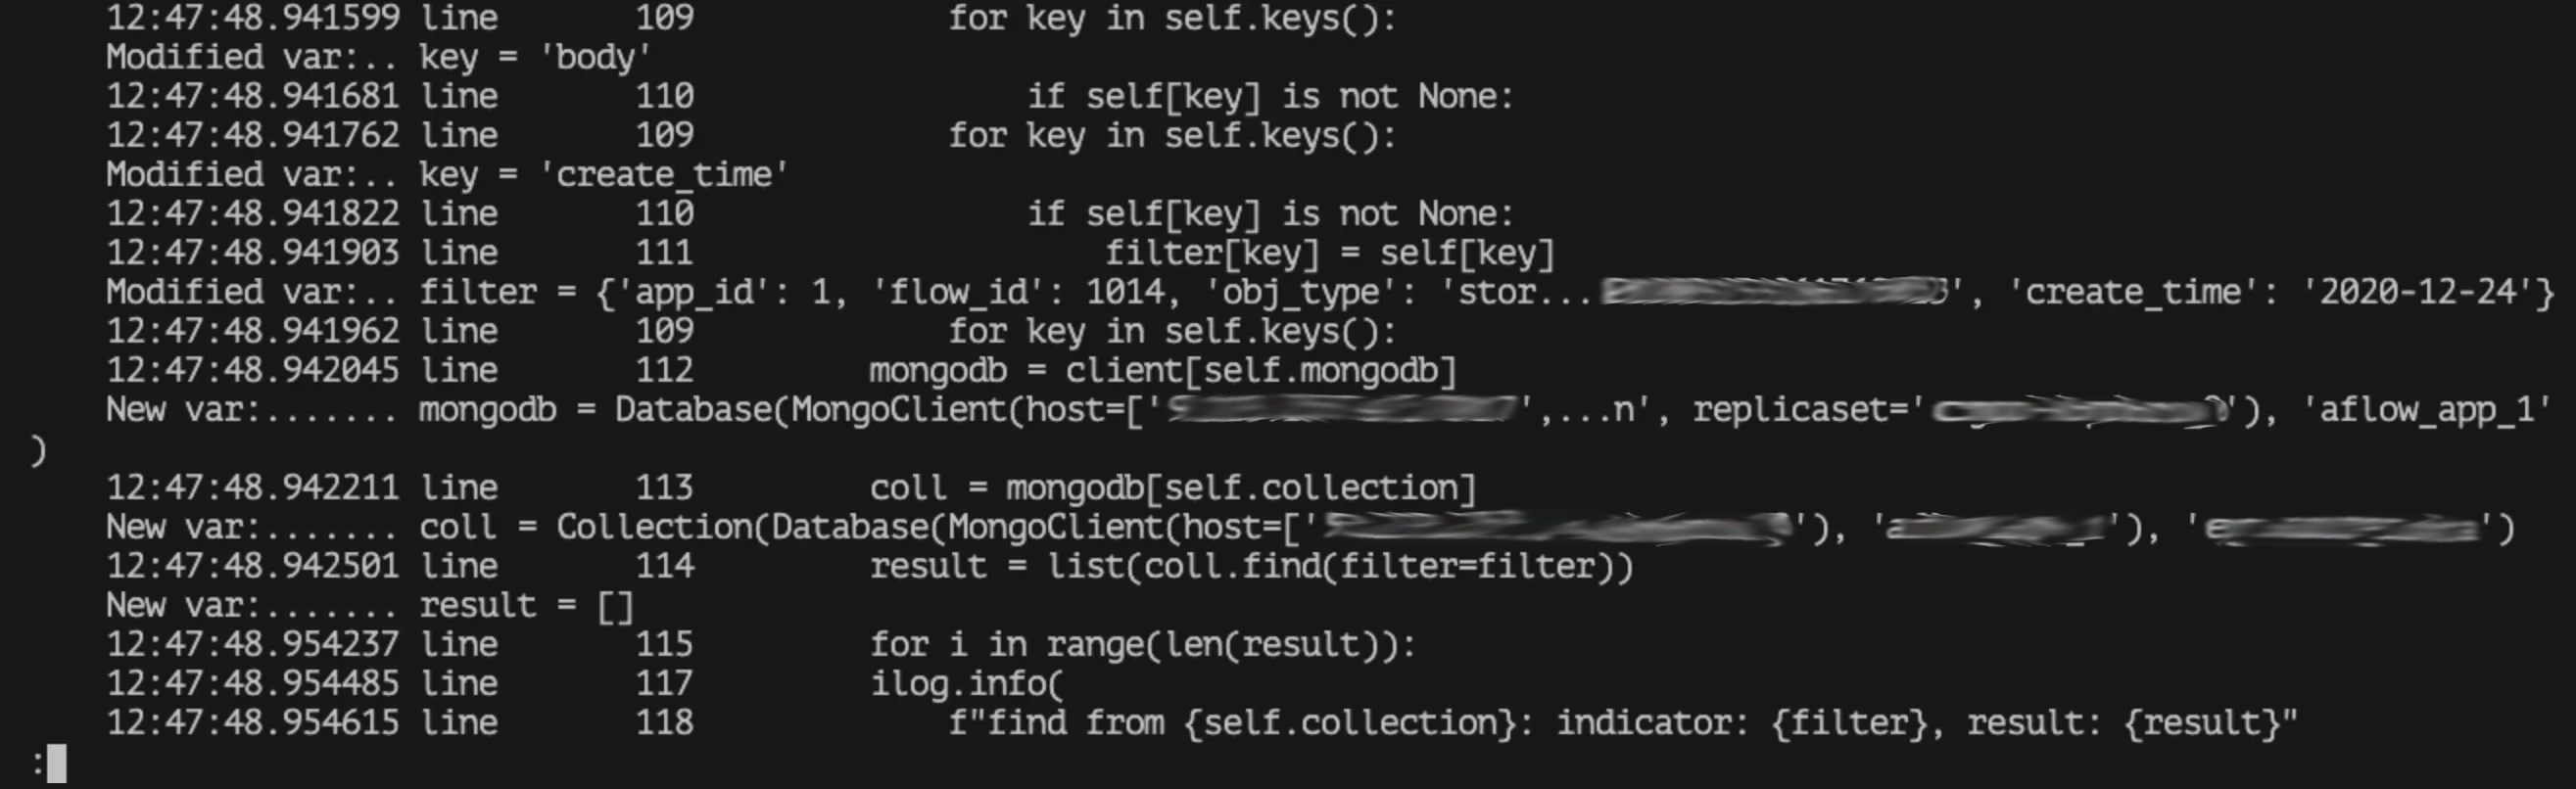
居然是卡在打日志这里了。
知道问题在哪里就好办多了,如果是日志的原因,又每天都是 12 点出问题,那基本就实锤是因为日志切分的问题了。
合
由于在多进程下面,logging 使用的 TimedRotatingFileHandler 日志切分是不安全的
1 | def doRollover(self): |
上面是 TimedRotatingFileHandler 默认的 rotate 函数。大致分为六步,先将当前日志文件的 file descriptor(后面简称 fd)关闭,防止继续有新的内容写入。然后根据预设好的 rotate 时间规则生成文件名。第三步,如果第二步生成的文件名已存在,则将给文件删除(这里是导致多进程会丢失日志的原因)。最后再将当前日志重命名为第二步生成的新文件名,然后根据预设的最大保留文件数,删除过于老旧的日志文件,最后更新 rotate 的时间。
可以看到,rotate 的过程完全没有加锁,是非原子的。
所以,为了能在多进程服务下安全使用 logging,需要对 TimedRotatingFileHandler 的 doRollover() 进行改写,下面是我们改写的 doRollover() 函数
1 | def doRollover(self): |
上面的改动加入了文件锁,使整个 rotate 的过程变成原子操作。
但是这里引入了两个新的问题:
- 在进行实质 rotate 操作之前没有先关闭 self.stream 文件流,使得其他进程还是会往缓冲区写入数据,所以在进行滚动操作的时候,依然会持续往日志文件写入内容,导致超出 rotate 时间节点的日志也会被写入到 rotate 后的文件中。
- fcntl.flock 是协议锁,并非强制锁(Linux 中 fcntl()、lockf、flock 的区别)
第一个问题,如果不严格要求日志的精准切分,其实也不算是问题,起码并不会引起程序的异常。而第二个问题就是导致前文在日志切分的时候产生大量 CLOSE_WAIT 阻塞的原因。
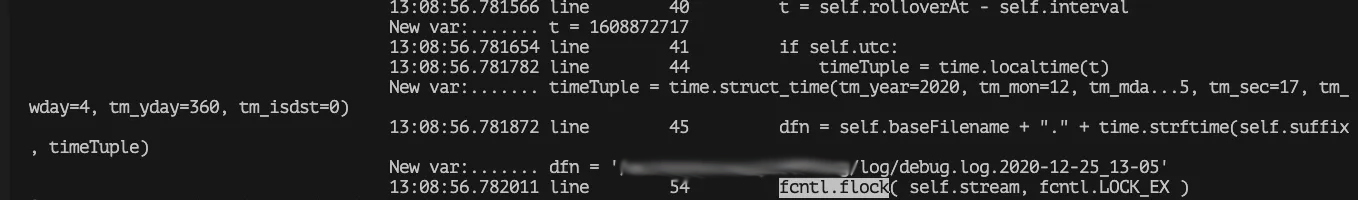
通过 pysnooper debug 可以看到产生大量 CLOSE_WAIT 的时候,所有进程都卡在了 fcntl.flock( self.stream, fcntl.LOCK_EX)这里,也就是真正执行 rotate 操作的那个进程,没有成功释放锁,导致后面在等待锁的进程全部被阻塞。
那为什么锁没有释放呢?按照设定,在第一个进入 doRollover() 的进程完成 rotate 操作的时候会 close self.stream ,随机 flock 会被解锁。看来并没有按照预定发展进行。
盘它!
有一个细节,虽然服务进程最后全都被阻塞了,但是 rotate 操作是成功了的,因为日志已经被成功 rename。从这一点来说,真相只有一个!那就是,self.stream.close() 的时候并没有成功释放锁。
分析原因,先来看下面这两段引文:
fcntl.flock(fd, operation)
Perform the lock operation operation on file descriptor fd (file objects providing a fileno() method are accepted as well). See the Unix manual flock(2) for details. (On some systems, this function is emulated using fcntl().)
flock( )
Locks created by flock() are associated with an open file description (see open(2)). This means that duplicate file descriptors (created by, for example, fork(2) or dup(2)) refer to the same lock, and this lock may be modified or released using any of these file descriptors. Furthermore, the lock is released either by an explicit LOCK_UN operation on any of these duplicate file descriptors, or when all such file descriptors have been closed.
If a process uses open(2) (or similar) to obtain more than one file descriptor for the same file, these file descriptors are treated independently by flock(). An attempt to lock the file using one of these file descriptors may be denied by a lock that the calling process has already placed via another file descriptor.
结合这两段引文可以的出以下结论:
- 锁定操作是对 fd 执行的
- 通过 fork()或者 dup()是可以将一个进程的 fd 复制给子进程的
- 通过 fork()或者 dup()出来的 fd 可以用来操作同一把锁,意思就是,fd1 和 fd2 都是从 fd0 dup()出来,在 进程 1 通过 fd1 获得锁的情况下,进程 2 同样可以通过 fd2 获得锁,锁就相当于失效了
- 在 2 的前提下,要想释放锁有两种方法,显式调用 LOCK_UN 或者所有 fd 被 closed
其实至此,稍加思考,问题已经可以被还原出来了。链路如下:
- 在 tornado 服务的入口文件启动主进程, import logging 并且复写了 TimedRotatingFileHandler 的 doRollover()函数,并且新建了日志输出流 self.stream(本质就是一个 fd),开始监听 0.0.0.0:xxxx 端口
- fork 出若干个作业子进程,于此同时将日志输出流的 fd.fileno() 一并复制了过去
- 当需要 rotate 日志的时候,其实锁是失效状态的,因为每个子进程都可以通过 self.stream 这个 fd 去获取到锁
等等…
如果锁是失效状态,那为什么还存在有进程被阻塞的情况呢?
那只能说明有进程通过非 dup()出来的 fd 申请了锁,这种情况下,锁是生效的,并且需要等待显式调用 LOCK_UN 或者主进程创建的 fd 和所有 dup() 出来 fd 被 closed ,锁才会被释放。但问题就出在这里,doRollover() 里面没有主动调用 LOCK_UN 来释放锁,并且,主进程只负责监听端口,分发请求,并不会参与到日志切分的过程当中,于是悖论就产生了,没有子进程主动调用 LOCK_UN ,主进程创建的 fd 永远不会 closed ,锁也就不会释放,于是在等待锁的子进程就会被卡住,直至所有的子进程都被卡住,进入到 CLOSE_WAIT 状态。
那到了这里就还剩下一个问题,非 dup()出来的 fd 是哪来的?
还是查代码,因为我们用的并非原生的 logging,而是对 logging 做了一层封装,模块名为 ilog。并且为了实现多进程下安全的按日期切分日志,创建了一个继承于 TimedRotatingFileHandler 的类 iTimedRotatingFileHandler 。而在更底层的父类 FileHandler 会 open() 一个 fd 传给父类 StreamHandler ,最后赋值给 self.stream 。这就是 import ilog 的时候做的。
上面一段话的意思就是,import ilog 的时候会创建 iTimedRotatingFileHandler 实例,并且会 open() 一个 fd 赋值给它的属性 stream。这是在主进程第一次 import ilog 的时候做的。
重点来了,那如果子进程当中,如果 ilog 是通过包结构的方式(from … import …)来 import 的呢?
import 的本质是将模块的信息添加到 sys.modules 当中,sys.modules 的本质是一个字典,通过 key-value 的形式查找 已经 import 的模块。而直接 import 和 form … import … 的产生的 key 是不同的。举例:
import ilog -> {“ilog”: “xxxxxx”}
from epflower import ilog -> {“epflower.ilog”: “xxxxxx”}
这就导致,ilog 这个模块会被重复加载到内存当中,并且是两个不同的东西。
所以当主进程采用直接 import ilog 这种方式引用,子进程当中一旦有地方使用了包结构的 import 方式,就会产生非 dup() 主进程的 fd。在等待获取锁的时候会被永久阻塞。
改
这里要改,方法不止一种,使用强制锁比较麻烦,还可以重写 emit() 函数,直接往对应日期的文件塞日志,去掉 rotate 机制。还有一个最简单的方法,不使用 self.stream 这个 fd 去获取锁,直接 open(self.baseFilename) 获取一个没有任何关联的 fd 来获取锁,一来可以避免 fork 进程,劝告锁失效的问题,二来只需要 close 一个 fd 就可以释放锁了。上代码!
1 | def doRollover(self): |
结
以上就是这次 CLOSE_WAIT 的分析过程,如有疑惑之处,抑或高明见解,欢迎讨论。
接下来还会写一篇关于多进程如何安全地写入文件的文章,深挖到 Linux 内核代码来探讨一下文件读写的过程与本质
链
[flock()](